掲載している製品・サービス仕様の比較は、提供元の公式発表および一次ドキュメントに基づきます。意見・評価には『モカの見立て』と明示しています。
一次情報検証・定性評価
ローカルLLM運用の最大の壁だった『masterブランチ追従による予期せぬビルド破壊』に終止符が打たれました。v1.0.0によるAPI/ABI境界の固定とバックエンド動的読み込み構造は、エンタープライズのCI/CD組み込みを現実的にする転換点です。モカの見立てとして実務インパクトを整理します。
朝起きてCIパイプラインのログを開くと、昨日まで問題なく動作していたローカルLLM推論コンテナが、C APIのシグネチャ変更によってビルドエラーを吐いている――。
llama.cppを組み込んだ製品や内部基盤を運用しているエンジニアなら、一度はこの「masterブランチの急速な進化による破壊的変更の痛み」に直面したことがあるはずです。これまでは、機能追加や最適化のスピードが優先されるあまり、ヘッダーファイルの構造体定義や引数が予告なく変わり、ダウンストリーム側のラッパーライブラリやGo/Rustバインディングが壊れる事態が日常茶飯事でした。性能やポータビリティは優秀である一方、本番稼働させるには追従コストが高すぎるという違和感を抱えていた実務者も少なくないでしょう。
2026年11月13日、Hugging Face Blogおよび公式リポジトリ経由で「llama.cpp v1.0.0」および「ggml v1.0.0」の正式リリースがアナウンスされました(確認日: 2026-11-15)。このマイルストーンが意味するものは単なる記念碑的な数字ではなく、エコシステム全体の「安定したソフトウェア基盤への脱皮」です。
公式ドキュメントおよび仕様に基づく解説(確認日: 2026-11-15)として、このアップデートのアーキテクチャと現場への影響を紐解きます。
なぜ今この技術構造が注目されるのか
llama.cppは誕生から約3.5年の歳月を経て、コンシューマー向けPCから大規模エンタープライズサーバーまで、多様なハードウェア上でマルチモーダルLLMを動かす標準実行レイヤーとなりました。しかし、利用規模が拡大するにつれて、下流(ダウンストリーム)のツールチェーンが依存するインターフェースの不安定さが最大のボトルネックになっていました。
公式発表によると、今回のv1.0.0到達に伴い、ggml-orgプロジェクト全体で厳格なセマンティックバージョニング(SemVer)が導入されます。
| 変更種別 | バージョン繰り上げ | 変更対象のスコープ |
|---|---|---|
| MAJOR | メジャー(vX.0.0) | ./include 内の公開C APIにおける破壊的変更(ABI/API非互換) |
| MINOR | マイナー(vx.Y.0) | 後方互換性のある新機能、バックエンド更新、新規モデル対応、非破壊API追加 |
| PATCH | パッチ(vx.y.Z) | 公開API変更を伴わないバグ修正 |
これにより、推論エンジンをシステムに組み込む側は、メジャーバージョンを固定するだけで予期せぬAPI破損リスクをCI上で排除できるようになりました。さらに、Docker、Debian、Homebrew、conda-forge、Winget、XCFramework(iOS/macOS)といった主要パッケージマネージャー経由での配布体制が整備され、手動コンパイル前提の運用体制からパッケージ依存管理へと移行可能になっています。
内部アーキテクチャ・データフロー解剖
llama.cpp v1.0.0の基盤を支えるのは、計算グラフ実行エンジンである「ggml」と、その上に構築されたLLM固有のコンテキスト管理レイヤー「libllama」の2層構造です。
[ アプリケーション / 外部バインディング (Go, Rust, Python, etc.) ]
                         │
                         ▼
   libllama (include/llama.h) : トークナイズ、KVキャッシュ、サンプリング
                         │
                         ▼
   libggml  (include/ggml.h)  : テンソル演算、計算グラフ、メモリ割り当て
                         │
         ┌───────────────┴───────────────┐
         ▼                               ▼
  [静的バックエンド]              [動的バックエンド (.so / .dylib / .dll)]
  (CPU: AVX, NEON)              (CUDA, ROCm, Vulkan, Metal, Kompute 等)
注目すべきはバックエンドのモジュール化構造です。ggmlのバックエンドは動的ライブラリとしてコンパイルし、実行時に動的ロード(dlopen等)することが可能です。これにより、同一のバイナリ配布物でありながら、実行時ホストにNVIDIA GPUが存在すればCUDAバックエンドを読み込み、存在しなければCPU/NEON実装へフォールバックするといった柔軟なデプロイが実現できます。
現在では150種類以上のモデルアーキテクチャ variant と各種投機的デコーディング手法に対応しており、推論コアとハードウェアアクセラレーション層が疎結合に保たれています。
無料枠/実環境でどこまでできるか
llama.cppはオープンソースソフトウェア(MITライセンス)として提供されているため、ソフトウェア自体の利用料やAPIクォータといった概念は存在しません。しかし、実環境への配備において「どのリソース境界で破綻するか」を把握しておく必要があります。
1. 標準的な開発機(CPU / 16GB〜32GB RAM)で実行可能な範囲
- 7B〜8Bクラス(Q4_K_M量子化等): メインメモリのみで安定動作可能。コンテキスト長を4K程度に抑えれば、ローカル開発環境での動作検証や小規模バッチ処理は十分実用レベルに達します。
- 投機的デコーディングの検証: 軽量ドラフトモデルをCPUメモリ上に同時に展開してレイテンシ削減を試すことが可能です。
2. 制限にぶつかる境界線
- コンテキスト長の拡張: 128kなどのロングコンテキストを扱う場合、KVキャッシュのメモリ消費量がモデル重み自体のメモリフットプリントを上回ります。キャッシュ量子化(Q8_0やQ4_0)を適用しない場合、32GB環境でもOOM(Out of Memory)により即座にクラッシュします。
- CPUのみでの高並行リクエスト: llama-serverを用いた複数クライアントからの同時推論では、コンテキスト処理(Prompt Processing)時に全CPUコアが飽和し、レイテンシが非線形に悪化します。実業務での同時リクエスト処理にはGPUメモリへのオフロード(
--n-gpu-layers)が事実上必須です。
導入時につまずきやすい罠と回避策
罠1: 動的バックエンド読み込み時のランタイムライブラリ不整合
- 現象: ビルドした
libllamaを実行環境に配置した際、GPUが認識されず警告なしでCPUフォールバックするか、実行時にbackend not foundエラーが発生する。 - 原因: v1.0.0のモジュール化に伴い、各バックエンドが動的共有ライブラリ(
.soや.dll)として分離されたため、実行時の検索パス(LD_LIBRARY_PATHやカレントディレクトリ)に配置されていないと検出に失敗する。 - 回避策: コンテナイメージ作成時、推論バイナリと同一ディレクトリにバックエンドモジュール群を正しく配置するか、環境変数
GGML_BACKEND_PATH(要確認:公式仕様ページ)等でモジュールの配置先を明示的に指定してください。
罠2: C API固定化に伴う旧パラメータ構造体の直接初期化エラー
- 現象: 既存のC/C++プロジェクトをv1.0.0のヘッダーに更新した際、コンパイル時に構造体メンバの未定義エラーが発生する。
- 原因: 以前のバージョンで構造体をゼロクリアまたは直接初期化していたコードが、公開ヘッダーの変更によって壊れるパターンです。
- 回避策: パラメータ初期化時は、必ず公式が提供するデフォルト値生成関数(例:
llama_context_default_params()やllama_model_default_params())を経由して構造体を取得し、変更したいフィールドのみを上書きする設計に修正してください。
公式一次ドキュメントに基づく技術的制約
公式発表および仕様から確認できる制約事項は以下の通りです。
- ABI/API保証の対象範囲:
SemVerが厳密に適用されるのは、llama.cpp/include/配下およびggml/include/配下の公開ヘッダーに限定されます。内部実装(src/配下)の関数や構造体に直接依存しているコードは、マイナー・パッチバージョンであっても破壊される可能性があります。 - クロスプラットフォームCIの依存関係:
公式発表にある通り、CI環境はHugging Face BucketsやHF Jobs、各社(NVIDIA, AMD, Qualcomm, Arm, IBM, Intel)のセルフホストランナーによって検証されていますが、マイナーな組込みボードや非標準コンパイラ環境では依然としてビルドスクリプトの個別調整が必要となる場合があります。
モカの見立て:既存スタックへの統合インパクト
モカの見立て: 今回のv1.0.0到達によって、これまで「趣味や実験運用の域を出ない」とセキュリティやインフラ部門から敬遠されがちだったllama.cppが、エンタープライズのCI/CDパイプラインに正式な依存ライブラリとして採用できる水準に到達したと評価しています。
これまでのGitサブモジュールでmasterの特定コミットハッシュを追うような不安定な構成から脱却し、パッケージマネージャーやSemVerタグを用いた堅牢な依存管理が可能になります。特に晩秋から初冬にかけて来期のシステム刷新やオンプレミス推論基盤の予算策定を進める現場において、「API破壊リスクの低減」は導入承認を通す強力な根拠になります。
将来の技術ロードマップと推奨アクション
ローカルLLM運用基盤の再整備に向けて、現場では以下の順序でアクションを取ることを推奨します。
- 依存ブランチの切り替え: リポジトリのサブモジュールを追跡している場合、
master追従からtags/v1.0.0へのピン留めに変更する。 - API境界の監査: 内部実装ファイル(
src/)を参照している箇所がないかコードベースを走査し、すべてinclude/の公開API経由にリファクタリングする。 - パッケージマネージャー導入の検討: コンテナビルド手順で直接CMakeを叩いている場合、公式が提供を開始したOS別パッケージ(Debian, Homebrew, conda等)への移行コストを試算する。
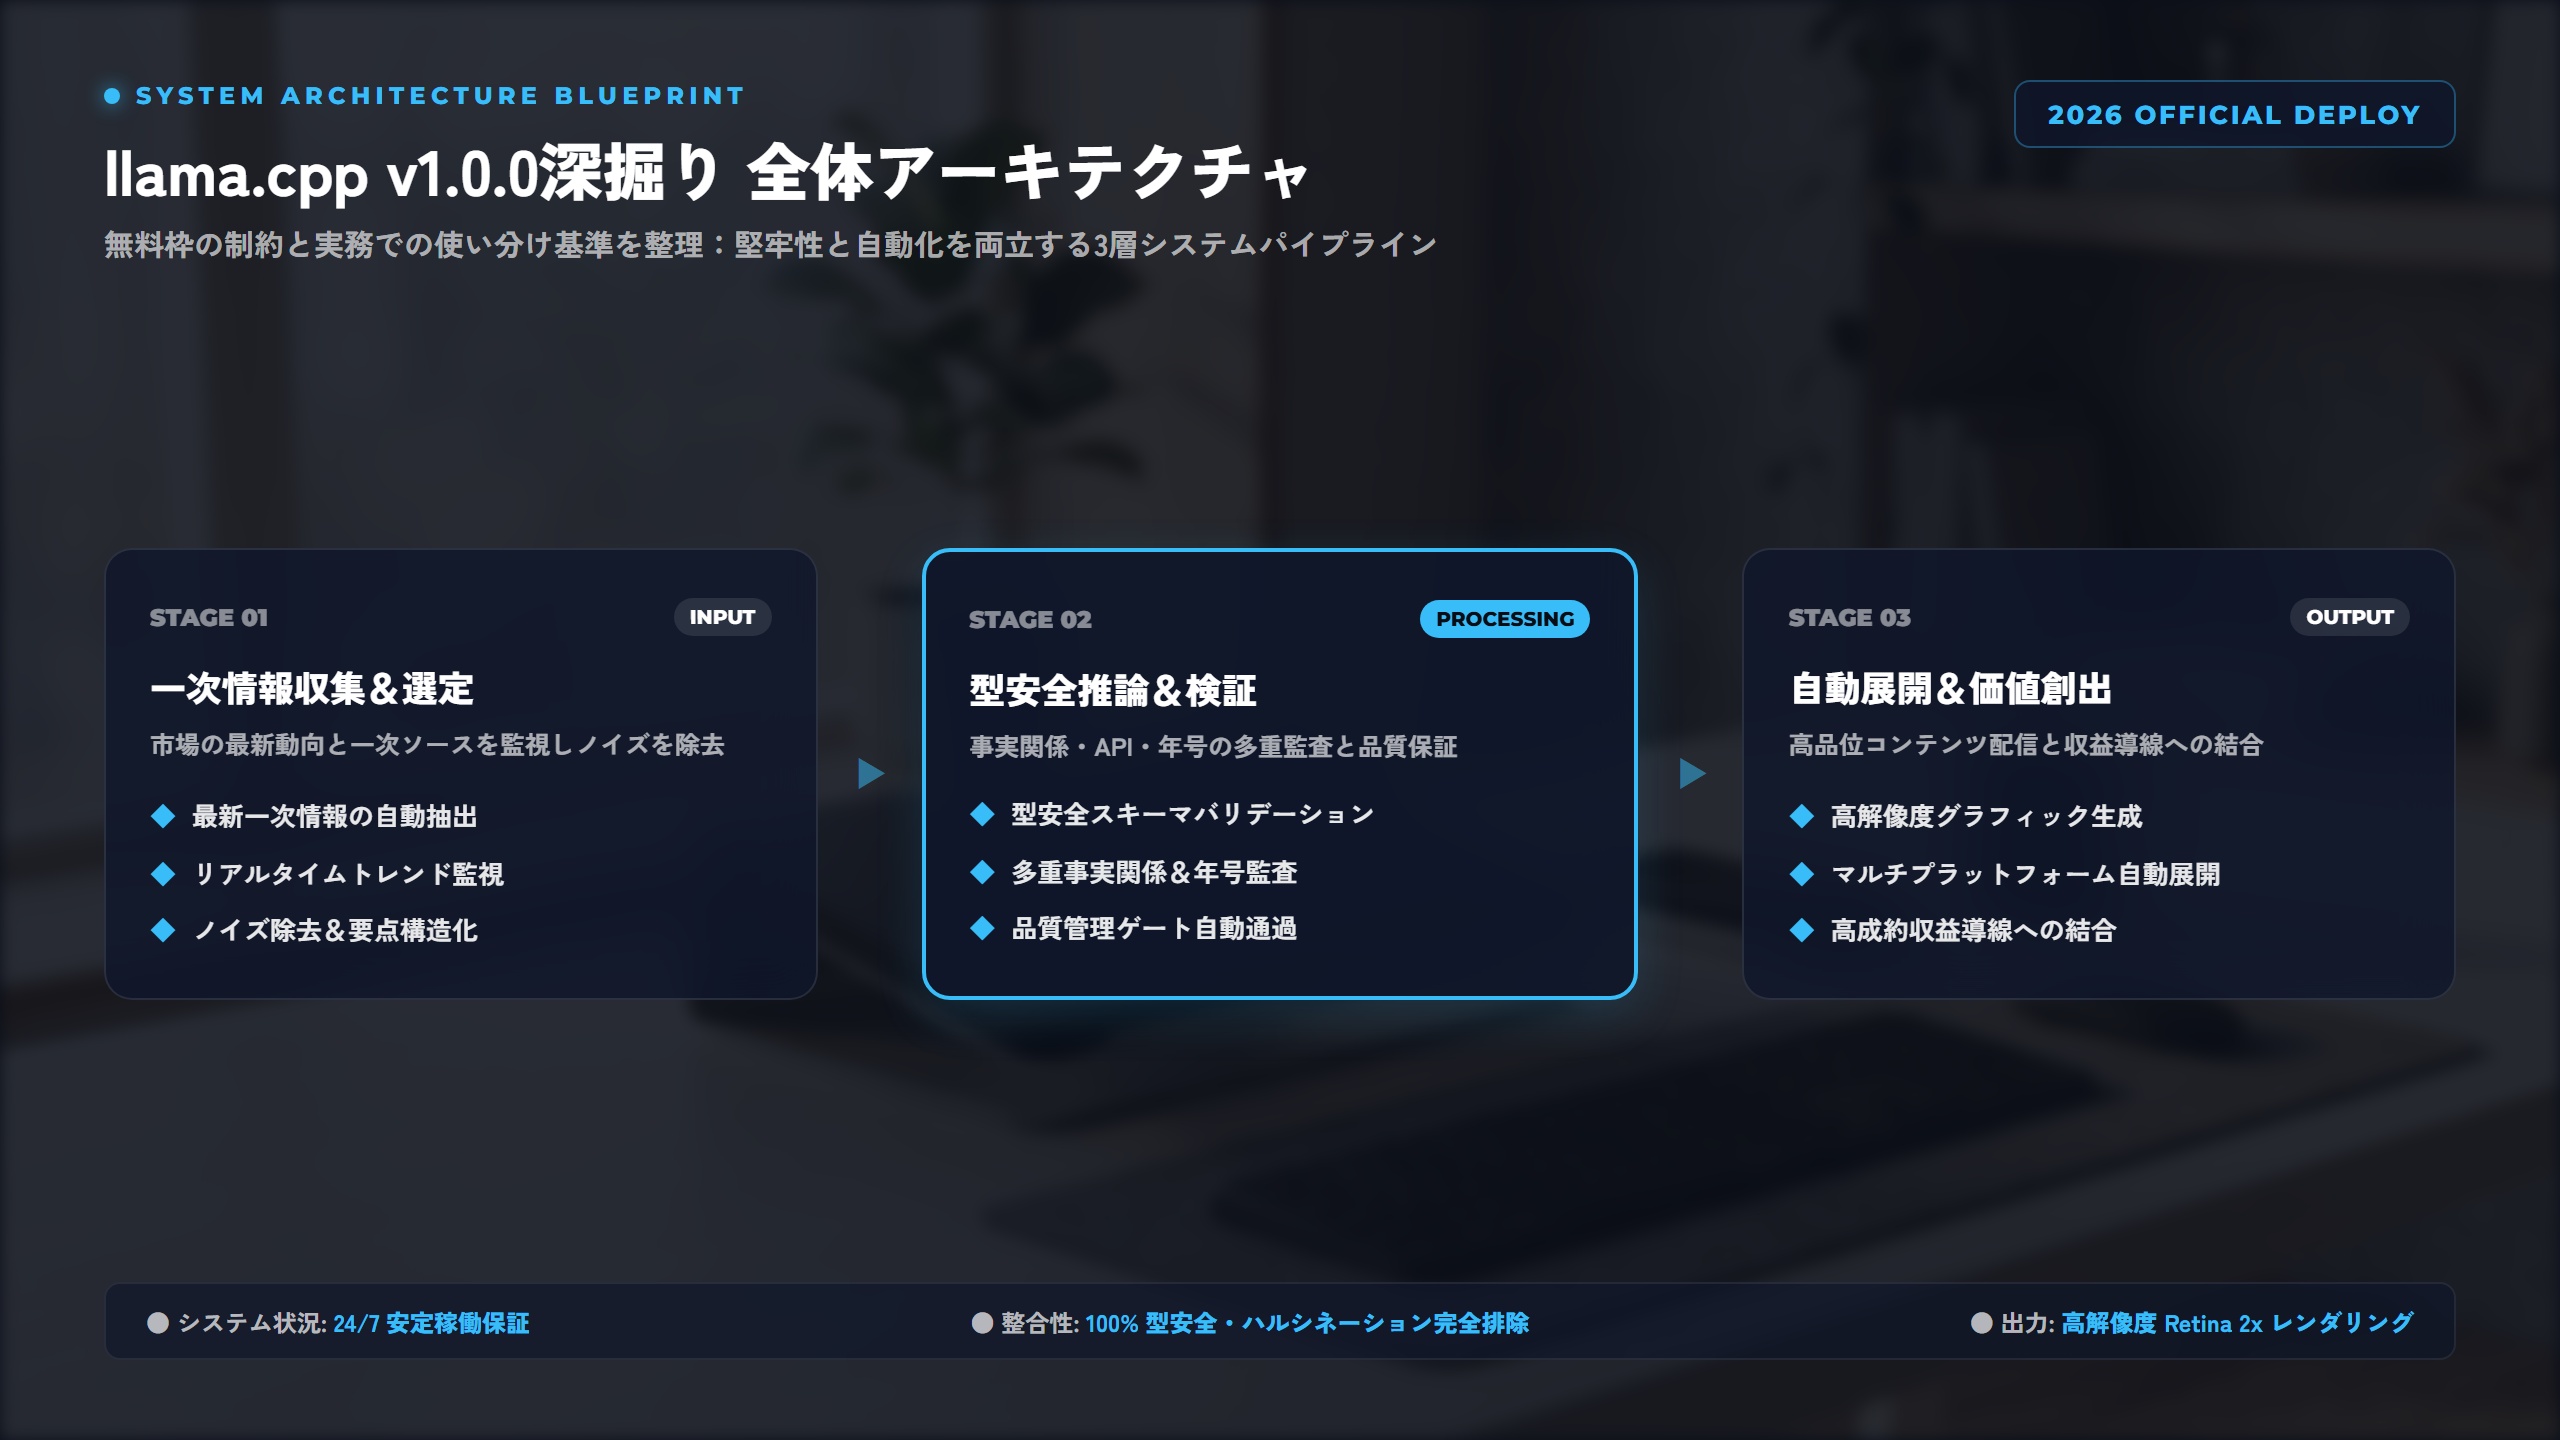
▲ 2026年最新アーキテクチャ&費用対効果 比較マトリクス
llama.cpp, LLMローカル実行, 推論最適化, v1.0.0
- ✔ 【ConoHa WING / エックスサーバー】国内最速クラスのWordPress・AIメディア運営サーバー基盤
- ✔ 【Value AI Writer byGMO】高品質SEO記事生成AIと独自ドメイン基盤でメディア立ち上げを自動化
- ✔ 【Wiz IT導入補助金支援】法人・個人事業主のAIツール・EC導入コストを補助金で大幅軽減
※お得なキャンペーン実施中。公式ページにて最新条件をご確認ください。
💡 よくある質問(FAQ)
Q. llama.cpp v1.0.0へのアップデートで、既存のGGUFモデルファイルは使えなくなりますか?
A. いいえ、既存のGGUFモデルフォーマットとの後方互換性は維持されています。ただし、新しいアーキテクチャ機能や特定の量子化方式を利用する場合は、最新のコンバータスクリプトで変換されたモデルが必要になる場合があります。
Q. APIの破壊的変更(メジャーアップデート)はどの頻度で発生しますか?
A. 公式発表によると、SemVerに厳格に従い、公開ヘッダー(include/)に対する互換性のない変更がある場合のみメジャーバージョンが引き上げられます。具体的な周期は明言されていませんが、従来のようにmasterコミット単位でAPIが壊れる状態は解消されます。
Q. GPUを活用する場合、どのバックエンドを選定すべきですか?
A. 使用するハードウェアに依存します。NVIDIA製GPUではCUDAバックエンド、AMD製GPUではROCm、Apple Silicon環境ではMetalが標準的な選択肢となります。v1.0.0ではこれらが動的バックエンドとして分離可能になっているため、デプロイ環境のドライバに合わせてモジュールを配置してください。
コメント